DeepSeek Logo DeepSeek 帮助中心
在线对话
DOCUMENTATION & COMPENDIUM · 典籍手卷

DeepSeek 使用指南与技术手册

提供涵盖网页版入口使用、服务器繁忙排查、Ollama 私有化部署、API 开放平台上下文缓存调优及 Harness 评估套件的权威解答。

全部典籍
网页版与排错
本地部署与硬件
API 开放平台
Prompt 提示词心法

DeepSeek-R1 纯强化学习大模型全网公测后,全球请求量呈指数级暴增。若在网页端偶遇服务器繁忙或打不开的情况,可采取如下策略:

排错建议四部曲:
1. 模型平滑降级:可在对话顶部切换至 DeepSeek-V3 通用大模型,响应速度更快,资源更充沛。
2. 错峰使用:避开每日 10:00-11:30、14:30-17:00 等高并发峰值区间。
3. API 开放平台通道:开发者建议直接使用 API 密钥进行调用,接口享有独立云端集群算力保障与 SLA 保障。
4. 本地离线运行:下载 Ollama 本地部署量化蒸馏版本,完全脱离公网环境自给自足。

DeepSeek 官方开源了 R1 全量 671B 权重及一系列由 Qwen、Llama 蒸馏而来的轻量化模型。只需一行命令即可在本地离线启动:

# 1. 运行最轻量蒸馏版(适用核显与日常轻薄本) ollama run deepseek-r1:1.5b # 2. 运行主流平衡版(建议 8GB 显存,如 RTX 3060/4060) ollama run deepseek-r1:7b # 3. 运行强力推理版(建议 16GB 显存,如 RTX 4080/4090) ollama run deepseek-r1:14b # 4. 运行高阶数学编程版(建议 24GB~32GB 显存或 Mac M系列大内存) ollama run deepseek-r1:32b

本地部署完全离线、不消耗流量、绝无数据上传风险,且永久免费。

DeepSeek 采用完全兼容 OpenAI 规范的 RESTful API。只需将 base_url 配置为 https://api.deepseek.com 即可无缝切换现有代码库。

curl https://api.deepseek.com/chat/completions \ -H "Content-Type: application/json" \ -H "Authorization: Bearer YOUR_DEEPSEEK_API_KEY" \ -d '{ "model": "deepseek-reasoner", "messages": [ {"role": "user", "content": "9.11 和 9.8 谁更大?请写出思维链。"} ], "stream": false }'
独家上下文缓存(Context Caching)机制:
若您的提示词(如系统角色设定、长篇知识库参考文本)开头部分在前序请求中已出现过,系统将自动命中缓存。命中的 Tokens 输入费率仅为 0.1 元/百万 Tokens,相比原始输入直接节约 90% 成本!

不同于依靠人工微调引导的传统大语言模型,DeepSeek-R1 的推理路径是经由强化学习自主探索构建的。在提示词使用上需牢记“少即是多(Less is More)”:

1. 避免过度添加思维引导词:无需在 Prompt 中写“请一步一步思考(Think step by step)”或硬性规范其推理格式,模型会自动进行深层次拆解。
2. 尽量少用复杂的 Few-Shot 示例:人为给出的示范案例往往具有思维局限性,反而会干扰模型跳脱框架自发探索最优数学与算法解法。
3. 明确定义输入与输出期望:清晰陈述背景边界条件、入参格式与目标判定要求,将中间逻辑推演全权交由模型完成。

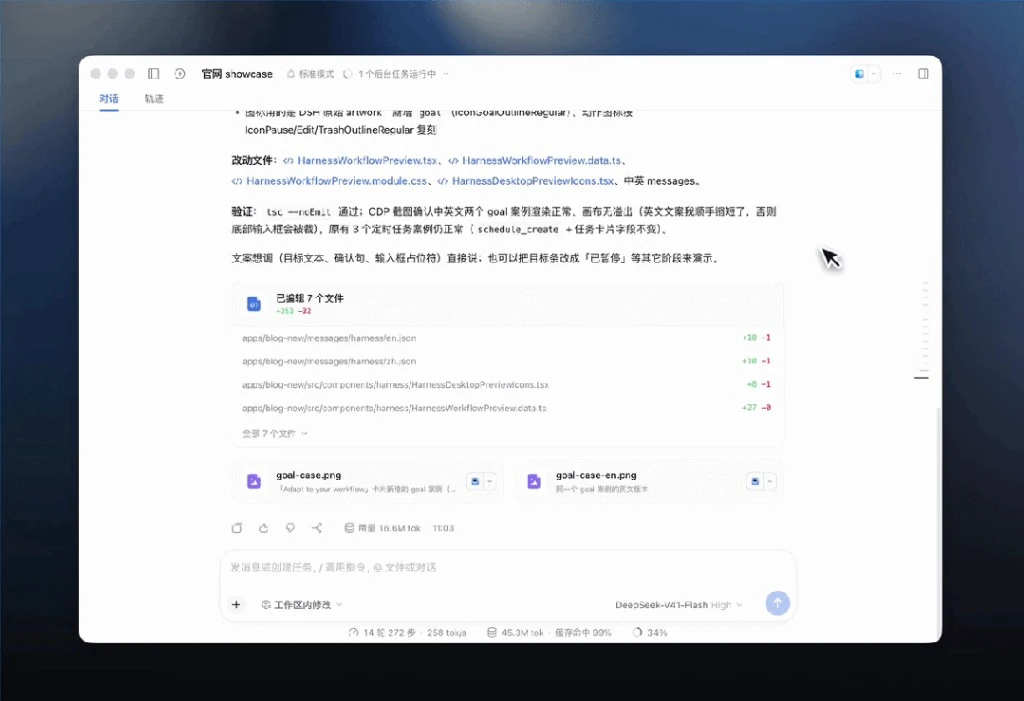
DeepSeek Harness 是深度求索开源的自动化任务评测与工作流编排套件。它集成了标准基准测试集(如 AIME、MATH、HumanEval 等),并内置了严格的测试用例验证沙箱,杜绝模型产生幻觉误判。

开发者可基于 Harness 脚本自动化运行百万级用例对比打分,以工业级标准评估不同微调权重或量化版本在长链路任务中的稳定表现。
DeepSeek 本地部署与显存分配对照表
本地量化蒸馏版本与硬件显存对照矩阵
DeepSeek API 开放平台调用监控
API 动态上下文缓存吞吐与计费监控