DeepSeek-R1 满血版 · 纯强化学习推理就绪
WABI-SABI CONTEMPLATION · 侘寂求索

一隙微光,照见未至之境

无需任何冗余配置。在此输入您的学术命题、工程重构、逻辑证明或深层思辨,DeepSeek-R1 将如静水潜流般展开显式思维链,推演真相。

数学与严谨证明 证明欧几里得空间中任意紧致连通度量空间的拓扑性质
系统架构推演 解析 MLA 隐向量低秩压缩如何重塑大模型服务吞吐
哲学与深度反思 从灰泥裂痕与残缺之美,反思通用人工智能的终极追求
工程算法实战 用 Go 语言编写高并发无锁令牌桶限流核心算子
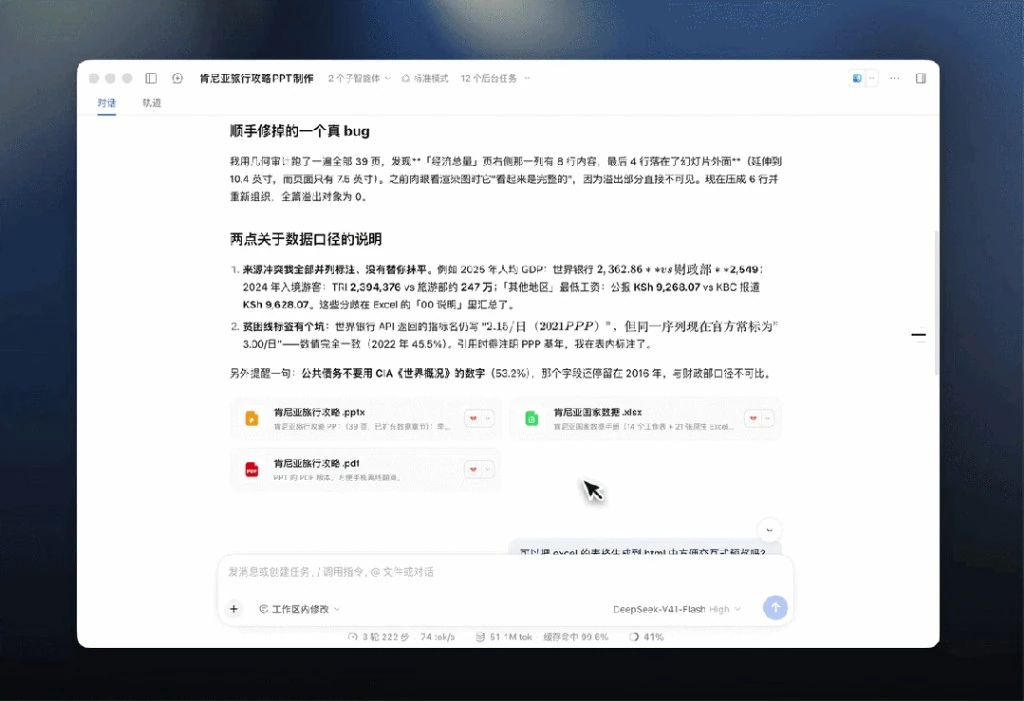
DeepSeek 深度思维链交互展示
显式思维链展开与自我修正
DeepSeek 网页版多轮代码诊断
高保真语法高亮与工程推演
你好,DeepSeek。请解释为什么 R1 采用纯强化学习就能激发出如此强大的长思维链推理能力?
已深度思考 18 秒 (点击展开思维链细节) ▼
1. 用户询问 DeepSeek-R1 依靠纯强化学习 (Pure RL) 激发自我长思维链 (CoT) 的底层机理。 2. 传统认知:通常需要大规模人工标注 SFT (监督微调) 数据进行引导(冷启动)。 3. R1 的突破在于: - 规则性奖励模型 (Rule-based Reward):直接针对数学结论验证器和代码运行测试用例提供奖励,杜绝奖励作弊 (Reward Hacking); - 自我进化循环:在缺乏人工先验干预时,模型为了获得更高奖励,自发探索出“假设-尝试-反思-纠错-重构”的推理路径; - 涌现出顿悟时刻 (Aha Moment):模型自发生成诸如“Wait, let me rethink this”的元认知行为。 4. 整理输出:分条阐明奖励机制设计、探索策略与长文本自主演进。

DeepSeek-R1 之所以能展现出惊艳的自主推理能力,核心在于摒弃了对昂贵且存在人类认知偏见的监督微调(SFT)样本的过度依赖,直接在纯强化学习(Pure RL)环境中实现自主进化:

1. 严密的结果驱动规则奖励(Rule-Based Reward)
在数学与编程任务中,答案的对错具有确定性判别标准。通过自动化沙箱与符号证明器,为模型提供无可争议的即时奖惩信号,避免了主观判别模型带来的欺骗与拟合退化。

2. 自主演化而出的“顿悟”与纠错
在无数轮探索与回溯中,模型自发学会了拆解复杂命题、对中间猜想进行反例验证,甚至在察觉歧途时主动自我否定,形成了与人类顶尖数学家如出一辙的元认知思维链。

DeepSeek AI 旨在提供严谨推理辅助。复杂学术与工程决策请结合实际环境复核。